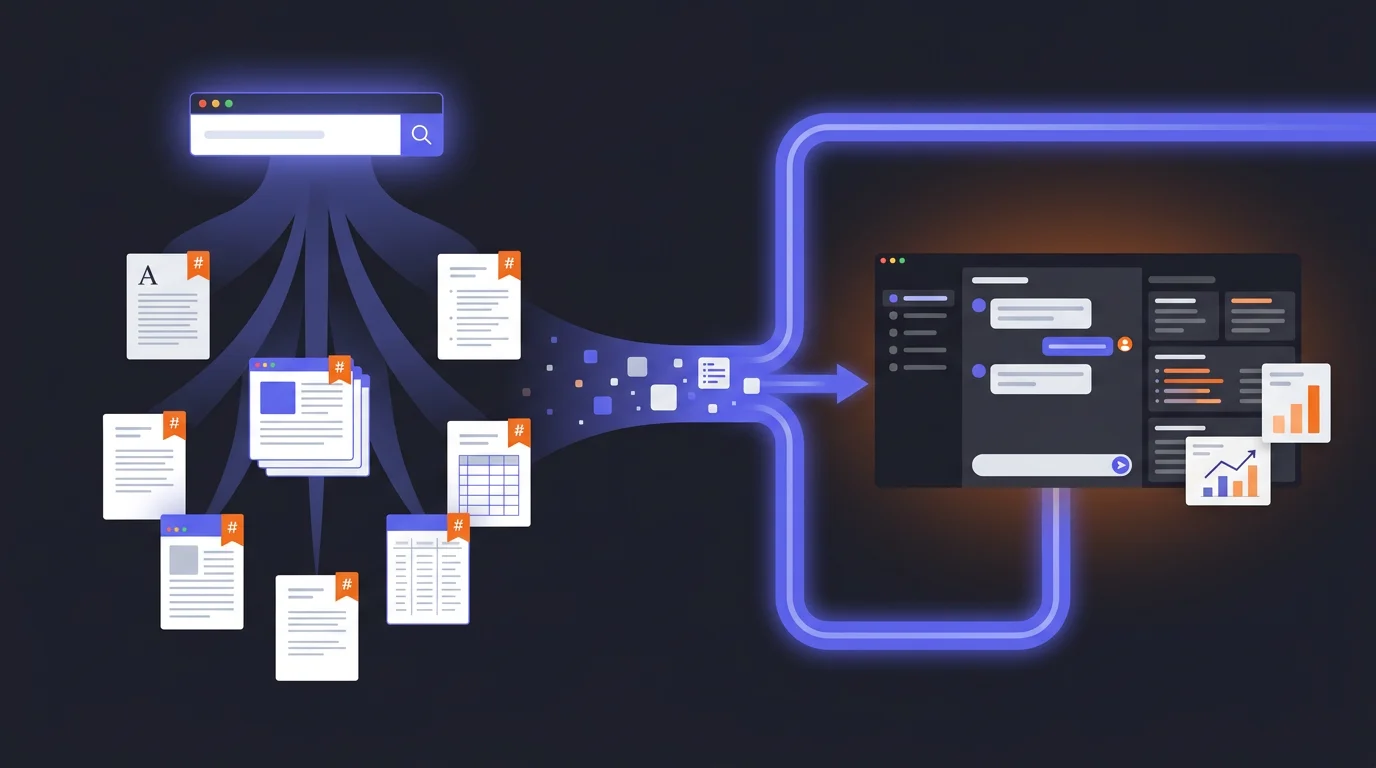
Die Recherche-Pipeline: Wie ich Perplexity und Claude zusammen nutze
Belegte Fakten finden und über sie nachdenken sind zwei verschiedene Aufgaben, und in einem einzigen Gespräch vertragen sie sich schlecht. Die Pipeline, die ich mit Perplexity für die Recherche und Claude für die Analyse gebaut habe, und warum die meisten sie heute mit dem Recherche-Modus ihres Assistenten umsetzen können.
 Fabian Mösli
Leseeinstellungen
Das Wichtigste in Kürze
- • Halte Finden und Denken auseinander. Lass die belegte Recherche als eigenen Durchgang laufen, im Recherche-Modus deines Assistenten oder in einem spezialisierten Tool wie Perplexity, und mach das Denken, die Analyse und das Schreiben danach in einem frischen Gespräch, mit der Recherchedatei als Ausgangspunkt.
- • Bevor die Recherche läuft, lasse ich Claude den Recherche-Prompt für mich schreiben — einen Auftrag mit 10 bis 15 konkreten Fragen, der die Recherche-Agenten gleichzeitig auf jeden Aspekt ansetzt.
- • Ich exportiere die Rechercheergebnisse als sauberes Markdown, bevor ich sie Claude übergebe. Markdown enthält keinen unsichtbaren Layout-Müll und ist darum das Format, das ein LLM am leichtesten lesen und verarbeiten kann.
In diesem Guide
Die meisten Menschen recherchieren und denken im selben Chat. Sie stellen eine Frage, nehmen die Antwort, lassen sie analysieren, dann einen Entwurf schreiben, alles in einem langen Gespräch. Ein Chat-Fenster für zwei Aufgaben.
Das ist, wie gleichzeitig Notizen zu machen und sich eine Meinung zu bilden. Technisch möglich. Nicht ideal.
Als ich diesen Guide zum ersten Mal schrieb, war meine Antwort: zwei Tools. Perplexity für die Recherche und Claude für alles danach, weil jedes eine Stärke hatte, die dem anderen fehlte. Das hat sich geändert. Die Recherche-Modi in den führenden KI-Assistenten sind so gut geworden, dass die meisten wohl kein separates Recherche-Tool mehr brauchen. Wer beruflich recherchiert, in der Wissenschaft, im Journalismus oder in der Marktforschung, für den lohnt sich ein spezialisiertes Tool weiterhin. Wo ich die Grenze ziehe, steht weiter unten.
Geblieben ist die Trennung. Belegte Fakten finden und über sie nachdenken sind zwei verschiedene Aufgaben, also lies die Schritte unten als zwei Phasen, egal in welchen Apps du sie umsetzt. Ich nenne unten Perplexity und Claude, weil ich die Pipeline dort aufgebaut habe. Dieselben Schritte funktionieren mit dem Recherche-Modus deines Assistenten und mit dem Chat-Assistenten, den dir deine Firma gibt.
Hier ist der Workflow.
Schritt 1: Deinen Recherche-Prompt mit Claude erstellen
Das ist der Schritt, den die meisten überspringen — und genau der, der den grössten Unterschied macht.
Wenn du eine Recherchefrage hast, ist dein erster Impuls, ein Recherche-Tool zu öffnen und sie einzutippen. «Welche regulatorischen Anforderungen gelten für die Personalvermittlung im Gesundheitswesen in der Schweiz?» Klingt vernünftig. Aber du lässt enorm viel Wert liegen, weil du einen Recherche-Modus wie eine Suchmaschine behandelst. Das ist er nicht.
Ein ernsthafter Recherche-Modus führt nicht nur eine einzelne Suche aus. Mit einem guten Prompt lässt er viele Suchen gleichzeitig laufen und führt zusammen, was er findet. Perplexity Deep Research zum Beispiel hat unter der Haube ein eigenes Denkmodell und startet Dutzende paralleler Recherche-Agenten, die jeweils einen anderen Aspekt deiner Frage gleichzeitig angehen. Sie recherchieren unabhängig voneinander, vergleichen Ergebnisse, lösen Widersprüche auf und fassen alles zu einer einzigen Antwort zusammen. Das ist ein ganzes Recherche-Team, das parallel arbeitet, und die meisten geben diesem Team nur einen Ein-Satz-Auftrag.
Fang also bei Claude an und lass es den Recherche-Prompt für dich schreiben.
So gehe ich vor:
“Ich muss zu [Thema] recherchieren. Hilf mir, einen umfassenden Recherche-Prompt für [dein Recherche-Tool] zu erstellen. Es wird viele parallele Recherche-Agenten starten, der Prompt sollte also 10 bis 15 konkrete Fragen enthalten, die das Thema aus unterschiedlichen Blickwinkeln angehen. Gib Einschränkungen dazu an, welche Quellen priorisiert werden sollen, auf welchen Zeitraum sich das Ganze konzentrieren soll, was ausgeschlossen werden soll, und lege das gewünschte Ausgabeformat fest.”
Claude liefert dann etwas wie das hier (Beispiel für eine Recherche zur Personalvermittlung im Gesundheitswesen):
Recherchiere die regulatorischen Rahmenbedingungen für Plattformen zur temporären Personalvermittlung im Gesundheitswesen in der Schweiz. Beantworte die folgenden Fragen:
1. Was sind die aktuellen SECO-Richtlinien für private Arbeitsvermittlungen im Gesundheitswesen? 2. Welche kantonalen Bewilligungspflichten gibt es, und wie unterscheiden sie sich zwischen den deutschsprachigen Kantonen? 3. Welche Datenschutz-Zertifizierungen sind für Plattformen verpflichtend, die Personendaten von Gesundheitsfachpersonen verarbeiten? 4. Wie haben sich die regulatorischen Rahmenbedingungen seit 2024 verändert? 5. Welche Strafen drohen bei Nichteinhaltung? 6. Welche aktuellen Durchsetzungsmassnahmen wurden gegen Personalvermittlungsplattformen ergriffen? 7. Wie unterscheiden sich die Schweizer Anforderungen von den EU-Regulierungen für Personalvermittlung? 8. Welche Branchenverbände setzen Standards in diesem Bereich? 9. Gibt es hängige Gesetzesvorlagen, die diesen Markt beeinflussen würden? 10. Welche Compliance-Frameworks nutzen etablierte Anbieter wie Adecco und Randstad in der Schweiz?
Priorisiere offizielle Behördenquellen, Publikationen von Branchenverbänden und Rechtsanalysen, die nach Januar 2025 veröffentlicht wurden. Schliesse generische Blogbeiträge und Marketinginhalte aus. Formatiere das Ganze als strukturiertes Markdown mit klaren Abschnittsüberschriften, Aufzählungspunkten für die wichtigsten Anforderungen und Fussnoten für die Quellen.
Siehst du den Unterschied? Statt einer vagen Frage gibst du dem Recherche-Tool einen vollständigen Rechercheauftrag. Jede dieser Fragen wird zu einem eigenen Strang, den die Agenten parallel verfolgen können. Die Einschränkungen filtern das Rauschen heraus. Das Ausgabeformat sorgt dafür, dass du im nächsten Schritt etwas hast, mit dem Claude arbeiten kann.
Diesen Prompt zu erzeugen dauert zwei Minuten. Die Recherche, die dabei herauskommt, ist um Welten besser.
Schritt 2: Recherchieren, wo die Quellen sind
Jetzt fügst du diesen Prompt in einen Recherche-Modus ein: den, der in deinen Assistenten eingebaut ist, oder für die grossen Jobs ein spezialisiertes Tool wie Perplexity Deep Research.
Warum ein Recherche-Modus und nicht ein normaler Chat? Weil ein Recherche-Modus dafür gebaut ist, hinauszugehen und nachzuprüfen. Jede Antwort kommt mit belegten Quellen. Er durchsucht das tatsächliche Web, liest die tatsächlichen Seiten und fasst zusammen, was er findet. Wenn er mir etwas sagt, kann ich draufklicken und es überprüfen. Das ist wichtig, wenn die Information in ein Strategiepapier, einen Businessplan oder eine Wissensdatenbank einfliesst, auf die sich andere Leute verlassen.
Mit deinem mehrperspektivischen Recherche-Prompt haben die Recherche-Agenten jetzt klare Marschbefehle. Statt selbst zu entscheiden, was recherchiert wird, decken sie jeden Aspekt ab, den du vorgegeben hast — regulatorische Anforderungen, Durchsetzungsgeschichte, Vergleich mit EU-Rahmenwerken, hängige Gesetzgebung, alles gleichzeitig.
Wenn der erste Durchgang bei einer bestimmten Frage noch zu oberflächlich ist, hake nach:
“Geh tiefer auf die Datenschutzanforderungen ein. Welche Zertifizierungen sind für Plattformen verpflichtend, die Daten von Gesundheitsfachpersonen verarbeiten?”
Das ist kein beiläufiges Stöbern. Das ist gezielte, belegte Informationsbeschaffung.
Der Markdown-Trick
Der Kniff, der die ganze Pipeline zum Laufen bringt: als Markdown exportieren.
Die meisten Leute kopieren Rechercheergebnisse in ein Dokument oder lesen sie einfach im Browser. Exportiere oder kopiere das Ergebnis stattdessen als Markdown-Datei (.md). Markdown ist reiner Text mit leichtgewichtigen Strukturelementen — Überschriften, Aufzählungspunkte, Links — und ohne Formatierungsmüll. Keine unsichtbaren Word-Formatvorlagen, keine PDF-Layoutartefakte. Sauberer, maschinenlesbarer Text.
LLMs lesen Markdown besser als jedes andere Format. In gewissem Sinn ist es ihre Muttersprache — fast ihre gesamten Trainingsdaten bestanden aus strukturiertem Text, und Markdown ist die verbreitetste Art, Text im Internet zu strukturieren. Einem LLM eine Markdown-Datei statt eines PDFs zu geben, ist, als würdest du einem Kollegen ein sauberes Briefing statt eines abfotografierten Faxes in die Hand drücken.
Schritt 3: Context in Claude aufbauen
Jetzt nehme ich diese Markdown-Datei — meine belegte, mit Quellen versehene Recherche — und lade sie in ein frisches Gespräch in Claude hoch. Aber ich fange nicht einfach an, Fragen zu stellen. Ich mache etwas, das sich zunächst kontraintuitiv anfühlt: Ich lasse Claude seine eigenen Anweisungen schreiben.
Hier ist der Prompt:
“Du bist mein leitender Strategieberater für [Bereich]. Ich habe ein Recherchedokument als deine primäre Wissensbasis hochgeladen. Bevor wir loslegen: Schreib dir selbst einen System-Prompt, der sicherstellt, dass du dich immer auf diese Recherche beziehst, nie generische Antworten gibst und bei Behauptungen konkrete Erkenntnisse aus dem Dokument zitierst.”
Claude liest die Recherche, versteht den Bereich und erstellt eine eigene Anweisung für sich selbst — im Grunde eine massgeschneiderte Persona, die auf deinen konkreten Daten beruht. Es konfiguriert sich selbst.
Das nenne ich Meta-Prompting: Statt dass du den perfekten Prompt schreibst, lässt du die KI den Prompt schreiben, basierend auf dem Context, den du ihr gegeben hast. Das funktioniert, weil die KI ihre eigenen Fähigkeiten und Grenzen besser versteht als die meisten Nutzer.
Nachdem Claude seine Selbstanweisungen generiert hat, sehe ich sie durch, passe an, was nicht passt, und dann arbeiten wir auf der Grundlage von echtem, belegtem Wissen statt der generischen Trainingsdaten der KI.
Schritt 4: Das Problem bearbeiten
Jetzt beginnt die eigentliche Arbeit. Und hier kommen Claudes Stärken zum Tragen — langformatiges Denken, strukturierte Analyse und die Fähigkeit, ein komplexes Gespräch zu führen, ohne den Faden zu verlieren.
Ich sage dann zum Beispiel:
“Identifiziere anhand der regulatorischen Recherche die drei grössten Compliance-Risiken für ein Startup, das in diesen Markt einsteigt. Schlag für jedes Risiko eine Massnahme zur Risikominderung vor.”
Claude greift auf die hochgeladene Recherche zurück — die konkreten, belegten Informationen, die der Recherche-Durchgang zusammengetragen hat, nicht seine generischen Trainingsdaten. Die Antworten kommen mit Verweisen auf die tatsächlichen Quellen, weil diese Quellen im Dokument stehen, mit dem es arbeitet.
Dann widerspreche ich:
“Dein zweites Risiko scheint übertrieben. In der Praxis setzen die meisten Kantone diese Anforderung bei Unternehmen mit unter 50 Mitarbeitenden nicht durch. Stell deine eigene Argumentation infrage — wo könntest du falsch liegen?”
So arbeite ich generell mit KI: nicht als einzelne Anfrage, sondern als iterative Konversation. Breit anfangen, die Ausgabe hinterfragen, verfeinern, tiefer gehen. Die KI wird mit jeder Runde besser, weil sie auf einem reicheren Context aufbaut.
Warum das besser ist als ein langes Gespräch
Die naheliegende Frage: Warum nicht einfach in einem normalen Chat fragen und weitermachen?
Drei Gründe.
Sourcing. Antwortet eine KI nur aus dem, was sie schon «weiss», zitiert sie manchmal eine Studie, die es nicht gibt, oder nennt eine Statistik ohne echte Quelle. Sie lügt nicht; sie hat gelernt, wie eine glaubwürdige Quellenangabe aussieht, und erzeugt eine, die in dieses Muster passt. Wenn ich aktuelle, überprüfbare Fakten brauche, brauche ich einen Durchgang, der hinausgeht und nachprüft. Die Recherche gibt mir Quellen, die ich prüfen kann. Die Analyse gibt mir eine Argumentation, auf der ich aufbauen kann. Unterschiedliche Aufgaben.
Separation of Concerns. Recherche und Analyse sind unterschiedliche kognitive Aufgaben. Sie in einem Gespräch zu vermischen, führt zu unklaren Ergebnissen — die KI recherchiert halb und analysiert halb, und macht beides nicht gut. Trennt man sie, erzwingt das saubere Übergaben.
Audit Trail. Die Markdown-Datei ist ein Artefakt. Wenn jemand meine Analyse sechs Monate später infrage stellt, kann ich auf die Recherche verweisen, die ihr zugrunde liegt, komplett mit Quellen und Daten. Hätte ich alles in einem einzigen Gespräch gemacht, wäre dieser Context über ein Chat-Protokoll verstreut.
Brauchst du noch ein separates Recherche-Tool?
Die meisten nicht. Meine Faustregel ist die Grösse des Jobs. Eine schnelle Websuche mit zehn oder zwanzig Treffern zum Auswerten erledigt mein normales KI-Tool problemlos. Bräuchte ich eine Liste möglicher Kunden in einem neuen Markt, mit einer Vertiefung zu jedem einzelnen, würde ich weiterhin ein spezialisiertes Tool nehmen. Ein Grund sind die Nutzungslimits: Eine tiefe Recherche verbraucht viel, und läuft sie in dem Tool, das ich den ganzen Tag nutze, frisst sie das Kontingent, das ich für alles andere brauche. Das drückt weniger als früher, aber es ist immer noch real. Gerade habe ich keine grossen Rechercheprojekte, darum ist mein eigenes Perplexity-Abo pausiert.
In meinem Haupttool passiert die Trennung immer öfter von selbst: Ein Planungsmodell schreibt den Auftrag, schickt günstigere Such-Agenten auf die Fragen los und denkt über das nach, was sie zurückbringen. Und wenn das KI-Tool deiner Firma keinen Recherche-Modus hat oder gar nicht ins Web darf, funktioniert die Pipeline trotzdem: Recherchiere mit dem Tool, das deine Firma freigegeben hat, oder trag ein paar gute Quellen von Hand zusammen, und bring sie als Datei mit.
Wenn es um etwas geht, halte das Sammeln belegter Fakten getrennt vom Denken, das du darauf aufbaust, ob das über zwei Tools läuft, über zwei Gespräche oder über zwei klar getrennte Phasen in einem Tool. Ein Durchgang findet. Der nächste denkt. Lass nicht ein einziges Gespräch beides machen.
Wann das übertrieben ist
Nicht alles braucht eine Pipeline. Wenn ich schnell eine E-Mail schreibe, Ideen sammle oder ein lockeres Gespräch über ein Thema führe, das ich gut kenne, öffne ich einfach Claude und lege los. Die Pipeline ist für Situationen, in denen genug auf dem Spiel steht, dass du belegte Recherche als Grundlage brauchst.
Gute Use Cases:
- Marktanalysen für ein neues Produkt oder einen Markteintritt
- Competitive-Intelligence-Briefings
- Regulatorische Recherche für Compliance-Entscheidungen
- Due Diligence zu potenziellen Partnern oder Anbietern
- Der Aufbau einer Wissensdatenbank für das KI-System deines Unternehmens
Nicht lohnenswert für:
- Eine E-Mail schreiben
- Schnelles Brainstorming
- Alles, wo «ungefähr richtig» reicht
Das grössere Bild
Diese Pipeline ist eigentlich der erste Schritt zu etwas Mächtigerem. Sobald du belegte Recherche als Markdown-Dateien hast, kannst du anfangen, eine dauerhafte Wissensdatenbank aufzubauen. Statt einmaliger Recherche, die in einem Chat-Gespräch verschwindet und vergessen wird, erstellst du strukturierte Artefakte, die sich mit der Zeit ansammeln.
Das ist die Grundlage dessen, was ich ein Company AI Operating System nenne — ein System, in dem die KI nicht nur aus ihren Trainingsdaten antwortet, sondern aus dem tatsächlichen, verifizierten Wissen deines Unternehmens. Die Recherche-Pipeline ist die Quelle für dieses Wissen.
Und sobald du diese Grundlage hast, ist der nächste Schritt noch interessanter: Statt dass du der KI Fragen stellst, lässt du die KI dich interviewen — und holst so das Wissen heraus, das in deinem Kopf ist, aber nie aufgeschrieben wurde.
Aber das ist eine Geschichte für einen anderen Guide.
Veröffentlicht: 2026-03-17
Zuletzt aktualisiert: 2026-10-22