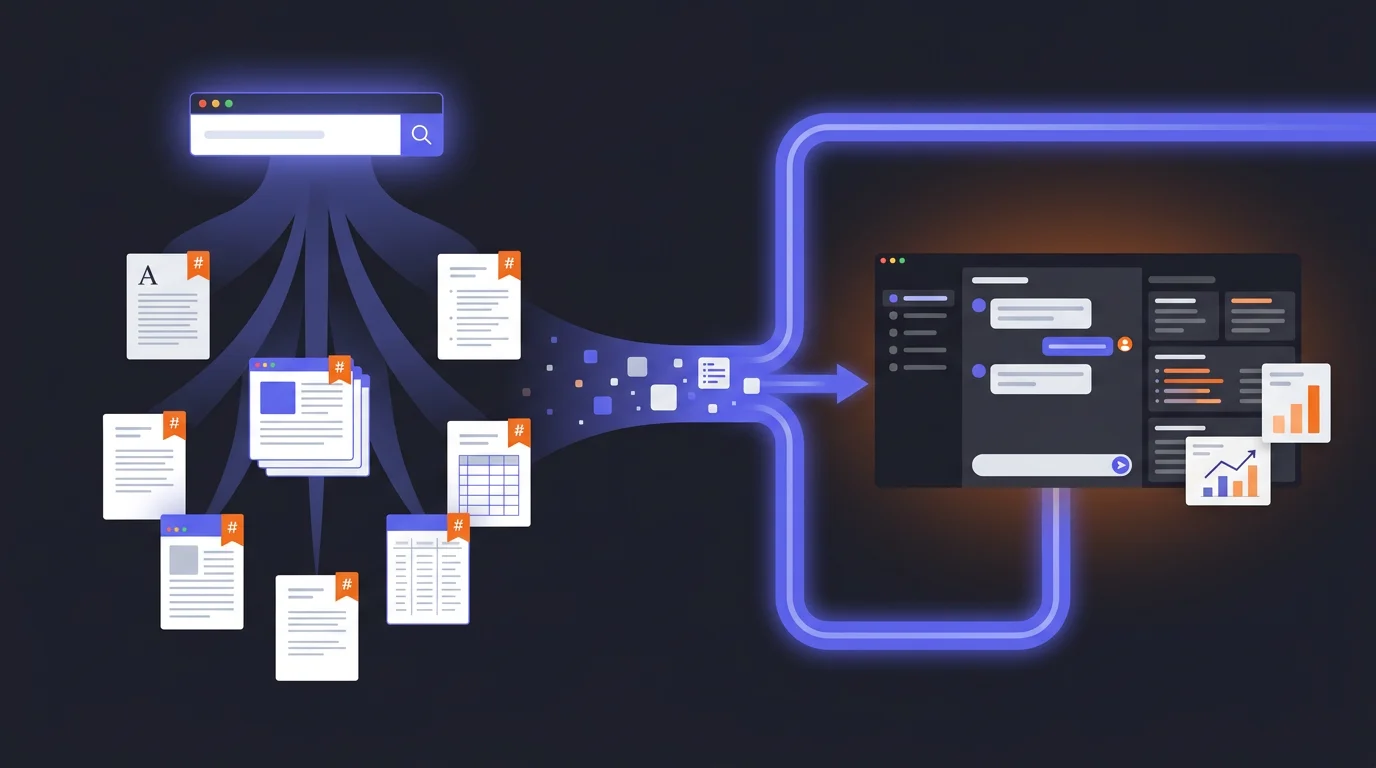
Le pipeline de recherche: comment j'utilise Perplexity et Claude ensemble
Trouver des faits sourcés et réfléchir à ces faits sont deux tâches différentes, qui se mélangent mal dans une seule conversation. Le pipeline que j'ai construit avec Perplexity pour la recherche et Claude pour l'analyse, et pourquoi la plupart des gens peuvent désormais le suivre avec le mode recherche de leur assistant.
 Fabian Mösli
Préférences de lecture
L'essentiel en bref
- • Séparez la recherche de la réflexion. Faites la recherche sourcée et citée dans un passage à part, avec le mode recherche de votre assistant ou un outil dédié comme Perplexity, puis menez le raisonnement, l'analyse et la rédaction dans une nouvelle conversation, avec le fichier de recherche comme point de départ.
- • Avant de lancer la recherche, je demande à Claude de rédiger le prompt de recherche — un brief de 10 à 15 questions précises qui envoie les agents de recherche explorer tous les angles à la fois.
- • J'exporte les résultats de la recherche sous forme de Markdown propre avant de les transmettre à Claude. Markdown ne contient aucun parasite invisible de mise en page, ce qui en fait le format le plus facile à lire et à analyser pour un LLM.
Dans ce guide
La plupart des gens font leur recherche et leur réflexion dans le même chat. Ils posent une question, prennent la réponse, demandent une analyse, puis un brouillon, le tout dans une seule longue conversation. Une fenêtre de chat pour deux tâches.
C’est comme prendre des notes et se forger une opinion dans le même souffle. Techniquement possible. Pas idéal.
Quand j’ai écrit ce guide pour la première fois, ma réponse tenait en deux outils: Perplexity pour la recherche et Claude pour tout ce qui vient après, parce que chacun avait une force qui manquait à l’autre. Ce n’est plus le cas. Les modes recherche intégrés aux principaux assistants IA sont devenus si bons que la plupart des gens n’ont probablement plus besoin d’un outil de recherche à part. Si la recherche est votre métier, dans le milieu académique, le journalisme ou les études de marché, un outil dédié vaut encore son prix. Je précise plus bas où je place la limite.
Ce qui n’a pas changé, c’est la séparation. Trouver des faits sourcés et y réfléchir sont deux tâches différentes: lisez donc les étapes ci-dessous comme deux phases, quelles que soient les applications que vous utilisez. Je cite Perplexity et Claude parce que c’est là que j’ai construit le pipeline. Les mêmes étapes fonctionnent avec le mode recherche de votre assistant et avec l’assistant de chat que votre entreprise met à votre disposition.
Voici le workflow.
Étape 1: concevez votre prompt de recherche avec Claude
C’est l’étape que la plupart des gens sautent — et celle qui fait la plus grande différence.
Quand vous avez une question de recherche, votre premier réflexe est d’ouvrir un outil de recherche et de la saisir. « Quelles sont les exigences réglementaires applicables au placement de personnel de santé en Suisse? » Ça semble raisonnable. Mais vous vous privez d’une grande partie de sa valeur, parce que vous traitez un mode recherche comme un moteur de recherche. C’est bien plus que ça.
Un vrai mode recherche ne lance pas une seule recherche. Avec un bon prompt, il en mène beaucoup en même temps et rapproche ce qu’il trouve. Perplexity Deep Research, par exemple, dispose de son propre modèle de raisonnement et crée des dizaines d’agents de recherche en parallèle, chacun chargé d’aborder votre question sous un angle différent. Ils cherchent de façon indépendante, comparent leurs résultats, résolvent les contradictions et réunissent le tout dans une seule réponse. C’est toute une équipe de recherche qui travaille en parallèle, et la plupart des gens lui donnent un brief d’une seule phrase.
Commencez donc par Claude et demandez-lui de rédiger le prompt de recherche pour vous.
Voici comment je m’y prends:
« Je dois faire des recherches sur [sujet]. Aidez-moi à rédiger un prompt de recherche complet pour [votre outil de recherche]. Il lancera de nombreux agents de recherche en parallèle. Le prompt doit donc comporter 10 à 15 questions précises qui abordent le sujet sous différents angles. Indiquez quelles sources prioriser, la période à couvrir, ce qu’il faut exclure et le format de sortie souhaité. »
Claude produira quelque chose comme ceci (exemple pour une recherche sur le placement de personnel de santé):
Étudiez le cadre réglementaire applicable aux plateformes de placement temporaire de personnel de santé en Suisse. Répondez aux questions suivantes:
1. Quelles sont les directives actuelles du SECO pour les agences privées de placement dans le domaine de la santé? 2. Quelles autorisations cantonales sont requises, et comment varient-elles entre les cantons germanophones? 3. Quelles certifications en matière de protection des données sont obligatoires pour les plateformes qui traitent les données personnelles du personnel de santé? 4. Comment le cadre réglementaire a-t-il évolué depuis 2024? 5. Quelles sanctions s’appliquent en cas de non-conformité? 6. Quelles mesures d’exécution récentes ont été prises contre des plateformes de placement? 7. Comment les exigences suisses se comparent-elles à la réglementation de l’UE en matière de placement? 8. Quelles associations professionnelles fixent des normes dans ce domaine? 9. Des projets de loi en cours pourraient-ils affecter ce marché? 10. Quels cadres de conformité sont utilisés en Suisse par des acteurs établis comme Adecco et Randstad?
Priorisez les sources gouvernementales officielles, les publications d’associations professionnelles et les analyses juridiques publiées après janvier 2025. Excluez les articles de blog génériques et les contenus marketing. Structurez la réponse en Markdown avec des titres de section clairs, des listes à puces pour les principales exigences et des sources en notes de bas de page.
Vous voyez la différence? Au lieu d’une question vague, vous donnez à l’outil de recherche un brief de recherche complet. Chacune de ces questions devient un axe distinct que ses agents peuvent poursuivre en parallèle. Les contraintes filtrent le bruit. Le format de sortie vous garantit un résultat dont Claude pourra se servir à l’étape suivante.
Il faut deux minutes pour générer ce prompt. Les résultats de la recherche sont nettement meilleurs.
Étape 2: faites la recherche là où sont les sources
Collez maintenant ce prompt dans un mode recherche: celui qui est intégré à votre assistant ou, pour les gros chantiers, un outil dédié comme Perplexity Deep Research.
Pourquoi un mode recherche plutôt qu’un chat normal? Parce qu’un mode recherche est conçu pour aller vérifier. Chaque réponse cite ses sources. Il cherche sur le web, lit les pages et synthétise ce qu’il trouve. Quand il me donne une information, je peux ouvrir la source et vérifier. Ce point compte lorsque l’information alimente un document stratégique, un plan d’affaires ou une base de connaissances sur laquelle d’autres personnes vont s’appuyer.
Avec votre prompt de recherche qui couvre plusieurs angles, les agents de recherche ont maintenant des consignes claires. Ils n’ont plus à décider seuls de ce qu’ils doivent chercher: ils couvrent en même temps tous les angles que vous avez précisés, des exigences réglementaires aux projets de loi en cours, en passant par l’historique des mesures d’exécution et la comparaison avec les cadres de l’UE.
Si le premier résultat reste trop superficiel sur une question précise, poursuivez:
« Approfondissez les exigences en matière de protection des données. Quelles certifications sont obligatoires pour les plateformes qui traitent les données du personnel de santé? »
Ce n’est pas une recherche improvisée. C’est une collecte ciblée d’informations, étayée par des sources.
L’astuce Markdown
Le geste qui fait fonctionner tout le pipeline: exporter en Markdown.
La plupart des gens copient-collent les résultats de recherche dans un document ou se contentent de les lire dans leur navigateur. Exportez plutôt le résultat ou copiez-le dans un fichier Markdown (.md). Markdown est du texte brut avec quelques balises de structure légères (titres, listes à puces, liens) et aucun parasite de mise en forme. Pas de styles Word invisibles, pas d’artefacts de mise en page PDF. Du texte propre et facile à analyser.
Les LLM lisent mieux le Markdown que n’importe quel autre format. C’est en quelque sorte leur langue maternelle: presque toutes leurs données d’entraînement étaient constituées de texte structuré, et Markdown est la manière la plus courante de structurer du texte sur internet. Donner un fichier Markdown plutôt qu’un PDF à un LLM, c’est comme remettre à un collègue un brief propre plutôt qu’un fax photocopié.
Étape 3: mettez Claude en contexte
Je prends alors ce fichier Markdown, qui contient ma recherche documentée et ses citations, et je l’importe dans une nouvelle conversation Claude. Mais je ne commence pas simplement à poser des questions. Je fais quelque chose qui paraît contre-intuitif: je demande à Claude de rédiger ses propres instructions.
Voici le prompt:
« Vous êtes mon conseiller principal en stratégie pour [domaine]. J’ai importé un document de recherche qui constitue votre principale base de connaissances. Avant que nous commencions à travailler, rédigez un system prompt pour vous-même qui vous oblige à toujours vous appuyer sur cette recherche, à ne jamais donner de réponses génériques et à citer des constats précis du document lorsque vous formulez une affirmation. »
Claude lit la recherche, comprend le domaine et produit ses propres instructions. En substance, il crée une personnalité sur mesure fondée sur vos propres données. Il se configure lui-même.
C’est ce que j’appelle le méta-prompting: au lieu d’écrire vous-même le prompt parfait, vous laissez l’IA le rédiger à partir du contexte que vous lui avez fourni. Ça marche parce que l’IA comprend mieux ses propres capacités et limites que la plupart des utilisateurs.
Une fois que Claude a généré ses propres instructions, je les relis, je corrige ce qui ne va pas, puis nous travaillons à partir de connaissances réelles et étayées par des sources plutôt qu’à partir des données générales d’entraînement de l’IA.
Étape 4: attaquez-vous au problème
Le vrai travail commence maintenant. Et c’est là que les forces de Claude entrent en jeu: raisonnement approfondi, analyse structurée et capacité à tenir une conversation complexe sans perdre le fil.
Je pourrais dire:
« À partir de la recherche réglementaire, identifiez les trois principaux risques de conformité pour une startup qui entre sur ce marché. Pour chaque risque, proposez une stratégie d’atténuation. »
Claude puise dans la recherche importée, c’est-à-dire dans les informations précises et étayées que le passage de recherche a rassemblées, plutôt que dans ses données générales d’entraînement. Les réponses renvoient aux sources réelles, puisque ces sources se trouvent dans le document sur lequel il travaille.
Puis je conteste sa réponse:
« Votre deuxième risque me semble exagéré. Dans la pratique, la plupart des cantons n’appliquent pas cette exigence aux entreprises de moins de 50 personnes. Remettez votre propre raisonnement en question: où pourriez-vous vous tromper? »
C’est ainsi que je travaille avec l’IA en général: dans une conversation itérative, pas avec une seule requête. Commencez par une question large, contestez le résultat, affinez, poussez plus loin. L’IA s’améliore à chaque tour parce qu’elle s’appuie sur un contexte plus riche.
Pourquoi c’est mieux qu’une seule longue conversation
Pourquoi ne pas simplement poser la question dans un chat normal et continuer?
Trois raisons.
Les sources. Quand une IA répond uniquement à partir de ce qu’elle « sait » déjà, il lui arrive de citer une étude qui n’existe pas ou une statistique sans véritable source. Elle ne ment pas: elle a appris à quoi ressemble une citation crédible et en produit une qui en a la forme. Quand j’ai besoin de faits actuels et vérifiables, il me faut un passage qui va vérifier. La recherche me donne des sources que je peux contrôler. L’analyse me donne un raisonnement sur lequel je peux m’appuyer. Deux tâches différentes.
La séparation des tâches. La recherche et l’analyse sont deux tâches cognitives différentes. Les mélanger dans une même conversation produit des résultats confus: l’IA cherche à moitié et analyse à moitié, sans bien faire ni l’un ni l’autre. Les séparer impose des passages de relais nets.
La traçabilité. Le fichier Markdown est une trace durable. Si quelqu’un remet mon analyse en question six mois plus tard, je peux lui montrer la recherche qui l’a alimentée, avec ses sources et ses dates. Si j’avais tout fait dans une seule conversation, ce contexte serait dispersé dans l’historique du chat.
Avez-vous encore besoin d’un outil de recherche dédié?
La plupart des gens, non. Ma règle empirique, c’est la taille du chantier. Une recherche rapide sur le web, avec dix ou vingt résultats à analyser, mon outil IA habituel s’en charge sans problème. S’il me fallait une liste de clients potentiels dans un nouveau marché, avec une analyse détaillée de chacun, je passerais encore par un outil spécialisé. En partie à cause des limites d’utilisation: une recherche approfondie consomme beaucoup, et la lancer dans l’outil que j’utilise toute la journée entame l’allocation dont j’ai besoin pour tout le reste. Cela pèse moins qu’avant, mais c’est toujours réel. En ce moment, je n’ai pas de grand projet de recherche, et mon propre abonnement Perplexity est donc en pause.
Dans mon outil principal, la séparation se fait de plus en plus d’elle-même: un modèle de planification rédige le brief, envoie des agents de recherche moins chers sur les questions et raisonne sur ce qu’ils rapportent. Et si l’outil IA de votre entreprise n’a pas de mode recherche ou ne peut pas du tout accéder au web, le pipeline fonctionne quand même: faites la recherche avec l’outil que votre entreprise autorise, ou rassemblez vous-même quelques bonnes sources, et apportez-les sous forme de fichier.
Quand l’enjeu est réel, séparez la collecte des faits sourcés du raisonnement que vous construisez dessus, que cela passe par deux outils, deux conversations ou deux phases clairement distinctes dans un seul outil. Un passage trouve. Le suivant réfléchit. Ne demandez pas à une seule conversation de faire les deux.
Quand le pipeline est superflu
Tout n’a pas besoin d’un pipeline. Si je rédige rapidement un e-mail, cherche des idées ou discute librement d’un sujet que je connais bien, j’ouvre simplement Claude et je commence à parler. Le pipeline sert aux situations où l’enjeu exige de partir d’une recherche étayée par des sources.
Bons cas d’usage:
- Analyse de marché pour un nouveau produit ou une entrée sur un nouveau marché
- Briefings de veille concurrentielle
- Recherche réglementaire pour des décisions de conformité
- Audit préalable de partenaires ou fournisseurs potentiels
- Construction d’une base de connaissances pour le système IA de votre entreprise
Ça n’en vaut pas la peine pour:
- Rédiger un e-mail
- Chercher rapidement des idées
- Tout ce pour quoi « à peu près juste » suffit
La vision d’ensemble
Ce pipeline est le premier pas vers quelque chose de plus puissant. Dès que vos recherches étayées par des sources sont enregistrées dans des fichiers Markdown, vous pouvez commencer à construire une base de connaissances durable. Au lieu de recherches ponctuelles qui restent dans une conversation et finissent par être oubliées, vous créez des artefacts structurés qui s’accumulent avec le temps.
C’est le socle de ce que j’appelle un Company AI Operating System: un système dans lequel l’IA ne répond pas seulement à partir de ses données d’entraînement, mais à partir des connaissances réelles et vérifiées de votre entreprise. Le pipeline de recherche est la source de ces connaissances.
Et une fois ce socle en place, la suite devient encore plus intéressante: au lieu de poser des questions à l’IA, vous laissez l’IA vous interviewer pour extraire les connaissances qui se trouvent dans votre tête mais n’ont jamais été mises par écrit.
Mais ce sera l’objet d’un autre guide.
Publié le: 2026-03-17
Dernière mise à jour: 2026-10-22